2026年10月24日至29日,全球计算语言学与自然语言处理领域顶尖学术会议EMNLP 2026(Conference on Empirical Methods in Natural Language Processing)在匈牙利布达佩斯举行。EMNLP由国际计算语言学协会(ACL)下属SIGDAT主办,是中国人工智能学会A类、中国计算机学会B类推荐国际会议,汇聚了来自全球高校、科研机构及企业的专家学者共同交流自然语言处理领域的前沿研究成果。
会议期间,学院数据挖掘实验室2024级硕士研究生林思婷、2023级本科生韩祎童同学受邀参会,赴匈牙利布达佩斯展示团队研究成果,并与与会学者围绕情感分类、中文语义纠错、大语言模型强化学习优化等前沿方向进行了深入交流。
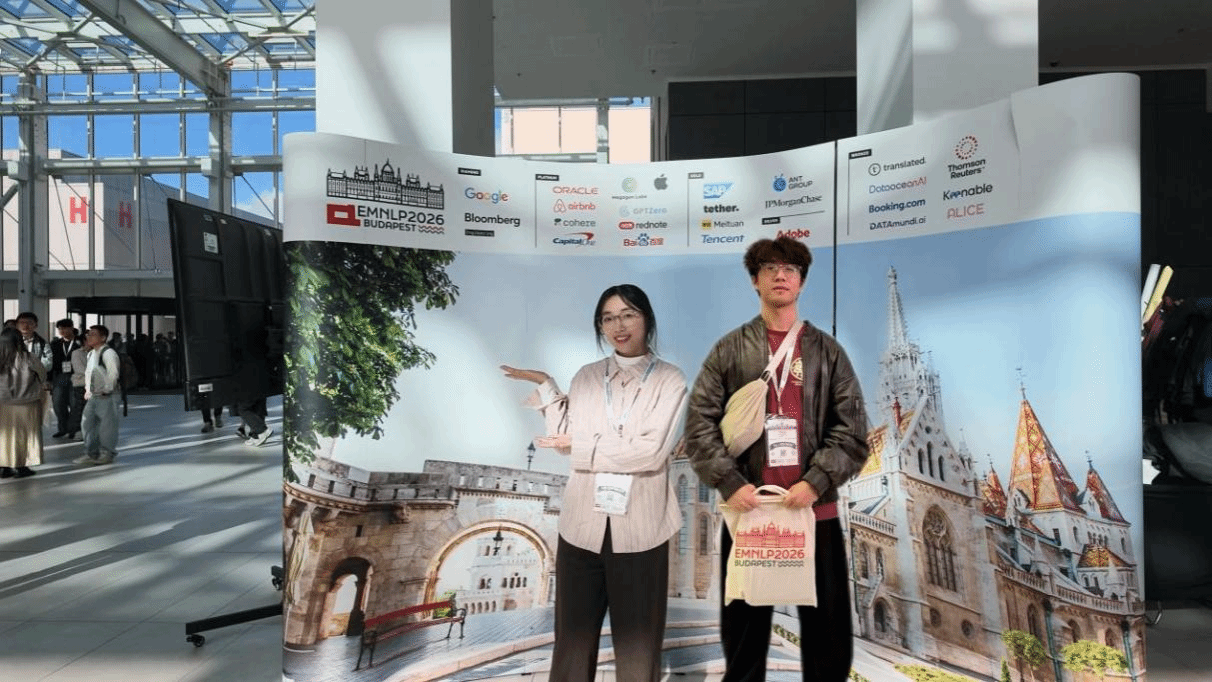
在本届会议上,我院共有5篇论文被录用,其中2篇线下参会并进行宣读(oral)的论文均来自数据挖掘实验室。会议期间,林思婷和韩祎童通过宣读论文展示了团队在细粒度情感分类与中文语义纠错领域的最新研究成果。
论文《How to Solve Noise and Hard Samples: Filtering and Difficulty-adaptive Augmentation for Fine-grained Negative Emotion Classification》的宣读由林思婷完成。该研究针对细粒度负面情感分类中标注噪声与语义边界难样本并存、模型判别能力受限及难样本学习不足等问题,提出噪声过滤与难度自适应难样本增强框架NF-DHSA。该框架通过困难度评分挖掘高风险样本,依托多视角机制区分噪声与有效难样本,再经难度自适应增强生成易学习样本,并以原型引导的双粒度对比学习强化类别边界。方法在多数据集与不同噪声场景下均具备良好的有效性与鲁棒性。
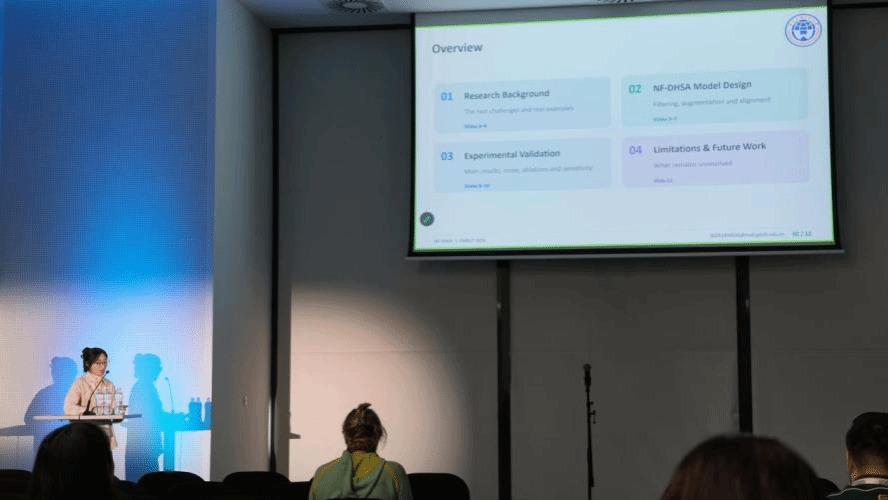
林思婷同学宣读论文
论文《VAA-CSEC:Vote-guided Advantage Allocation for Chinese Semantic Error Correction》的宣读由韩祎童完成。该研究聚焦中文语义纠错任务中语义错误类型复杂、奖励信号稀疏且分配偏差大等挑战,构建了包含思维链引导、监督微调、强化学习与自一致性解码在内的多阶段训练框架。在强化学习阶段,研究团队在 GRPO 算法基础上提出全新的 GLPO 算法,通过多路径投票机制动态分配优势奖励,有效缓解了单一路径奖励估计不准的问题,显著提升了中文语义纠错的准确率与生成一致性。
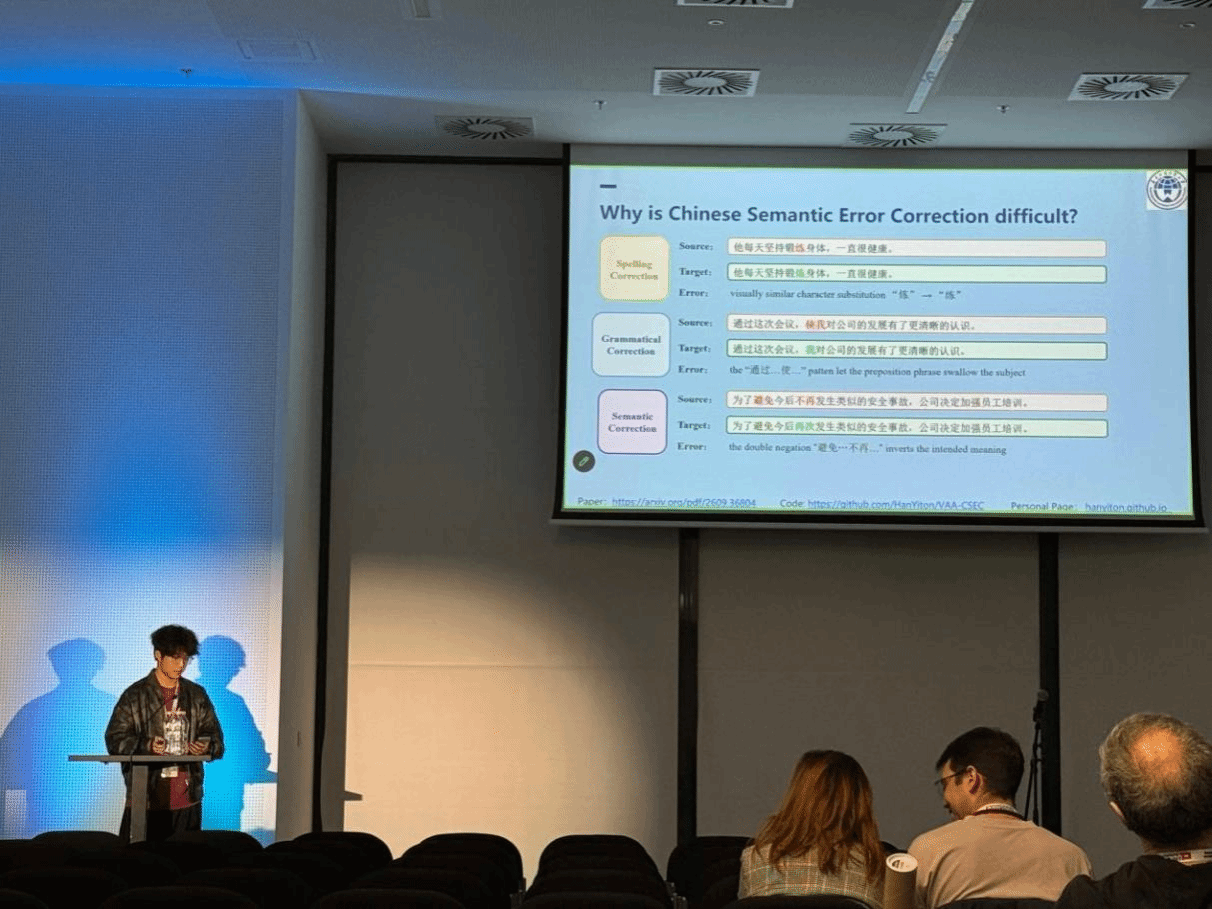
韩祎童同学宣读论文
展示过程中,来自海内外高校、科研院所及产业界的众多学者就两项工作所关注的噪声—难样本精准区分、投票式优势分配算法等问题提问交流,对研究的创新性与实用价值给予了积极评价。此次两篇论文的录用与展示,不仅展示了学院在人工智能与自然语言处理方向的科研实力,也为后续拓展国际学术交流、深化跨机构合作奠定了良好基础。
近年来,为推动我校与国(境)外高校及科研机构的学术交流,跟踪学科国际前沿动态,提升研究生培养质量与国际化水平,学校出台了《广东外语外贸大学研究生短期国(境)外访学和参加国际学术会议资助办法》(广外校〔2022〕42 号),并积极支持研究生参与短期国(境)外访学项目及高水平国际学术会议。据初步统计,近两年已有近20位同学获得学校研究生院国际学术会议资助。
初稿:林思婷、韩祎童
初审:陈彩萍
复审:王连喜
终审:麦培年